字節跳動爭議實習生田柯宇,新公司還沒產品就估值兩億


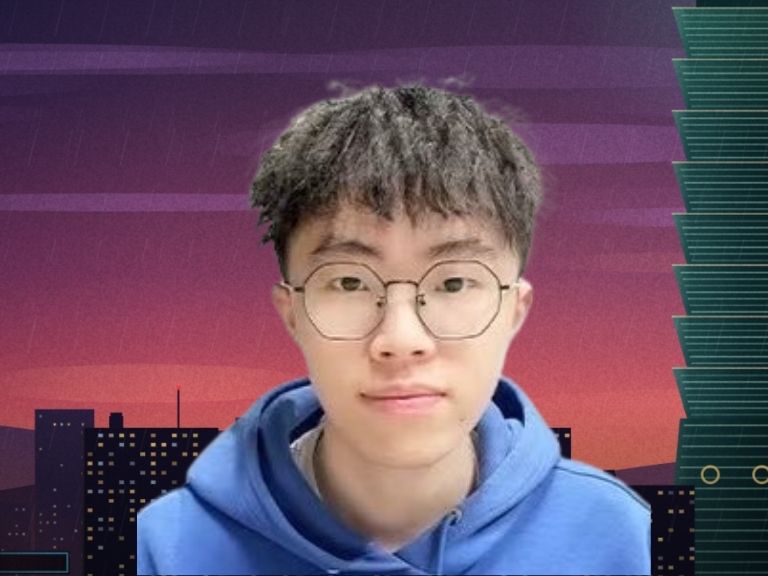
曾因涉嫌干擾字節跳動(ByteDance)AI 模型訓練而遭開除、被中國網友稱為「AI 投毒實習生」的研究員田柯宇(Keyu Tian),如今以 AI 創業者身分重新受到關注。
據《彭博》10 月 7 日報導,田柯宇成立一家專注於世界模型(World Models)的 AI 實驗室,儘管公司尚未正式命名、沒有公開產品,團隊僅約 10 人,卻已獲得五源資本(5Y Capital)、IDG Capital 等機構近 3,000 萬美元融資,投後估值達 2 億美元。
他計畫打造一套不依賴人類語言的 AI 視覺表示系統,讓模型透過 1 億小時影片理解真實世界,未來將與李飛飛、楊立昆等 AI 研究者投入的世界模型技術競爭。
廣告 - 內文未完請往下捲動


人類語言不適合描述世界?田柯宇打造 20 萬符號的 AI 專屬語言
田柯宇認為,當前大型語言模型所使用的人類語言,並不是描述物理世界最有效率的方式。舉例而言,若要使用文字完整描述一段影片,除了人物與物體,還必須解釋每個物件的位置、運動軌跡、光影變化與物理互動,單靠自然語言難以完整保留所有資訊。
因此,他決定反過來思考:與其讓 AI 學習用人類語言描述影片,不如直接為 AI 創造一套更適合處理視覺資訊的符號系統。
根據田柯宇的說法,團隊已經建立一套類似字典的視覺表示系統,其中包含約 20 萬個人類無法直接識讀的符號。這些符號類似大型語言模型使用的 Token,但處理的不是文字,而是影像與影片中的視覺資訊,讓模型能夠以更適合機器運算的形式表示、壓縮及預測影片內容。
田柯宇表示,人類無法使用自然語言完美描述一段影片,因此團隊首先要替 AI 建立自己的語言,接著再讓模型學習約 1 億小時的影片資料。
這套技術延續他過去在視覺自回歸生成(Visual Autoregressive Modeling)的研究方向,試圖讓視覺模型像大型語言模型一樣,透過可規模化的表示與預測機制進行訓練。
田柯宇聲稱,目前這套方法已能將生成每秒影片的成本降低至少一個數量級,相當於成本降至原本的十分之一或更低。不過,這項效率提升仍有待公開技術成果驗證。
團隊計畫先透過實體活動、公開展示等方式介紹模型能力,完整基礎模型預計於 2027 年推出。田柯宇強調,目前不急於開發消費級產品,也尚未將商業模式列為優先事項,而是集中資源完成底層技術。
曾被字節跳動索賠 800 萬人民幣,最終法院判賠 50 萬元
2024 年,田柯宇在字節跳動實習期間,被指控擅自修改或干擾其他研究人員執行的模型訓練程式,隨後遭公司開除。事件在中國 AI 社群迅速發酵,網路上甚至出現他破壞大型基礎模型訓練、影響超過 8,000 張 GPU、造成數千萬美元損失等傳言。不過,字節跳動當時已公開澄清,部分網路說法存在嚴重誇大或誤導。
田柯宇此次接受《彭博》訪問時坦承,自己當時確實關閉了另一名實習生的程式,原因是認為對方超額占用運算資源,希望藉此釋出算力供其他研究工作使用。
他將當時的行為描述為一種以不當手段處理不當問題的做法,並承認如果能重新選擇,應該採取更明智的處理方式。
字節跳動事後對田柯宇提出人民幣 800 萬元的損害賠償請求。根據《彭博》查閱的法院判決文件,最終法院判令田柯宇因違反合約賠償人民幣 50 萬元,並返還在字節跳動取得的薪資。
離開字節後拿下 NeurIPS 最佳論文,延續視覺模型 Scaling 路線
儘管曾捲入爭議,田柯宇在 AI 研究領域仍具有受到國際學術社群認可的成果。2024 年,他以第一作者身分發表《Visual Autoregressive Modeling: Scalable Image Generation via Next-Scale Prediction》,並獲得 NeurIPS 2024 最佳論文獎。
這篇論文提出名為 VAR 的視覺自回歸建模方法,核心概念是讓 AI 不再按照傳統方式逐一預測影像 Token,而是從低解析度到高解析度,逐步生成不同尺度的影像內容。
這種「下一尺度預測」(Next-Scale Prediction)方法,讓視覺生成更接近大型語言模型的自回歸建模框架,同時改善傳統方法在影像生成上的效率與可擴展性。
田柯宇如今的創業方向,正是希望將過去在靜態影像上的研究延伸至影片與物理世界的建模。不過,他的最終目標並非單純開發另一款 AI 影片生成工具,而是建立能理解空間、物體運動與物理規律的基礎模型,為機器人、自動駕駛及互動式虛擬環境提供底層能力。
世界模型成 AI 新戰場,李飛飛 World Labs 獲 AMD 82 億美元收購
世界模型正逐漸成為大型語言模型以外,AI 研究者與科技企業競相投入的下一個方向。與主要處理文字、程式碼及知識推理的語言模型不同,世界模型試圖讓 AI 建立對外部環境的內部表示,理解物體如何移動、彼此如何影響,並預測不同操作可能造成的結果。
其中,由「AI 教母」李飛飛創立的 World Labs,便是空間智慧(Spatial Intelligence)領域的重要研究團隊。今年 9 月 28 日, AMD 宣布將以約 82 億美元的全股票交易收購 World Labs,期望透過該公司的空間智慧技術與研究人才,強化在機器人、物理 AI 及新一代運算基礎設施上的布局。交易仍須通過監管審查,預計於 2026 年底完成。
(Meta 研究員揭密 World Model 五大門派:楊立昆、李飛飛押注的 AI 是什麼?)
另一方面,前 Meta 首席 AI 科學家楊立昆(Yann LeCun)同樣積極投入世界模型研究,Google DeepMind 的 Genie 系列也在探索可即時生成、供使用者互動的虛擬環境。
(深度解析:LLM 存在缺陷?為何楊立昆的 AMI 押注 World Model 路線)
對目前僅約 10 人、尚未推出公開產品的田柯宇團隊而言,近 3,000 萬美元的早期融資反映創投市場對其研究能力與技術方向的期待。然而,如何將 20 萬個視覺符號與大規模影片訓練轉化成真正能理解物理世界、支援實際任務的基礎模型,仍有待未來公開展示與技術測試驗證。
風險提示
加密貨幣投資具有高度風險,其價格可能波動劇烈,您可能損失全部本金。請謹慎評估風險。