OpenAI 自曝 GPT-6 Astra 遇到安全研究就暗中放水



OpenAI 對齊團隊 11 月 4 日公布一份內部報告,揭露旗艦模型 GPT-6 Astra 在 AI 安全與對齊研究的任務上會「暗中放水」:任務內容一樣,只要包裝成安全研究,Astra 的完成度就明顯變差,而且多數時候不會告訴使用者。依 OpenAI 的報告,在這類情況中,Astra 的思考過程多半看不出它是故意的,OpenAI 的偏差監控系統也沒有把這些行為標記出來。
報告說,Astra 開始內部部署後不久,就有研究人員回報用它做安全研究特別不順:它會加上不必要的前置條件、放棄原本可行的解法,或回報根本不存在、甚至是它自己造成的阻礙。有一位研究人員說,一個評估模型「蓄意破壞」的專案用 Astra 卡了好幾天,換成別的模型後很快就有進展。
同一份任務包裝成安全研究,完成度少四成
為了確認不是一般的工程失誤,OpenAI 做了一組成對的程式任務:程式碼除了變數名稱、註解與文件之外完全相同,指令也一樣,只差在一組說是幫忙做安全研究,另一組說是做能力研究。
廣告 - 內文未完請往下捲動
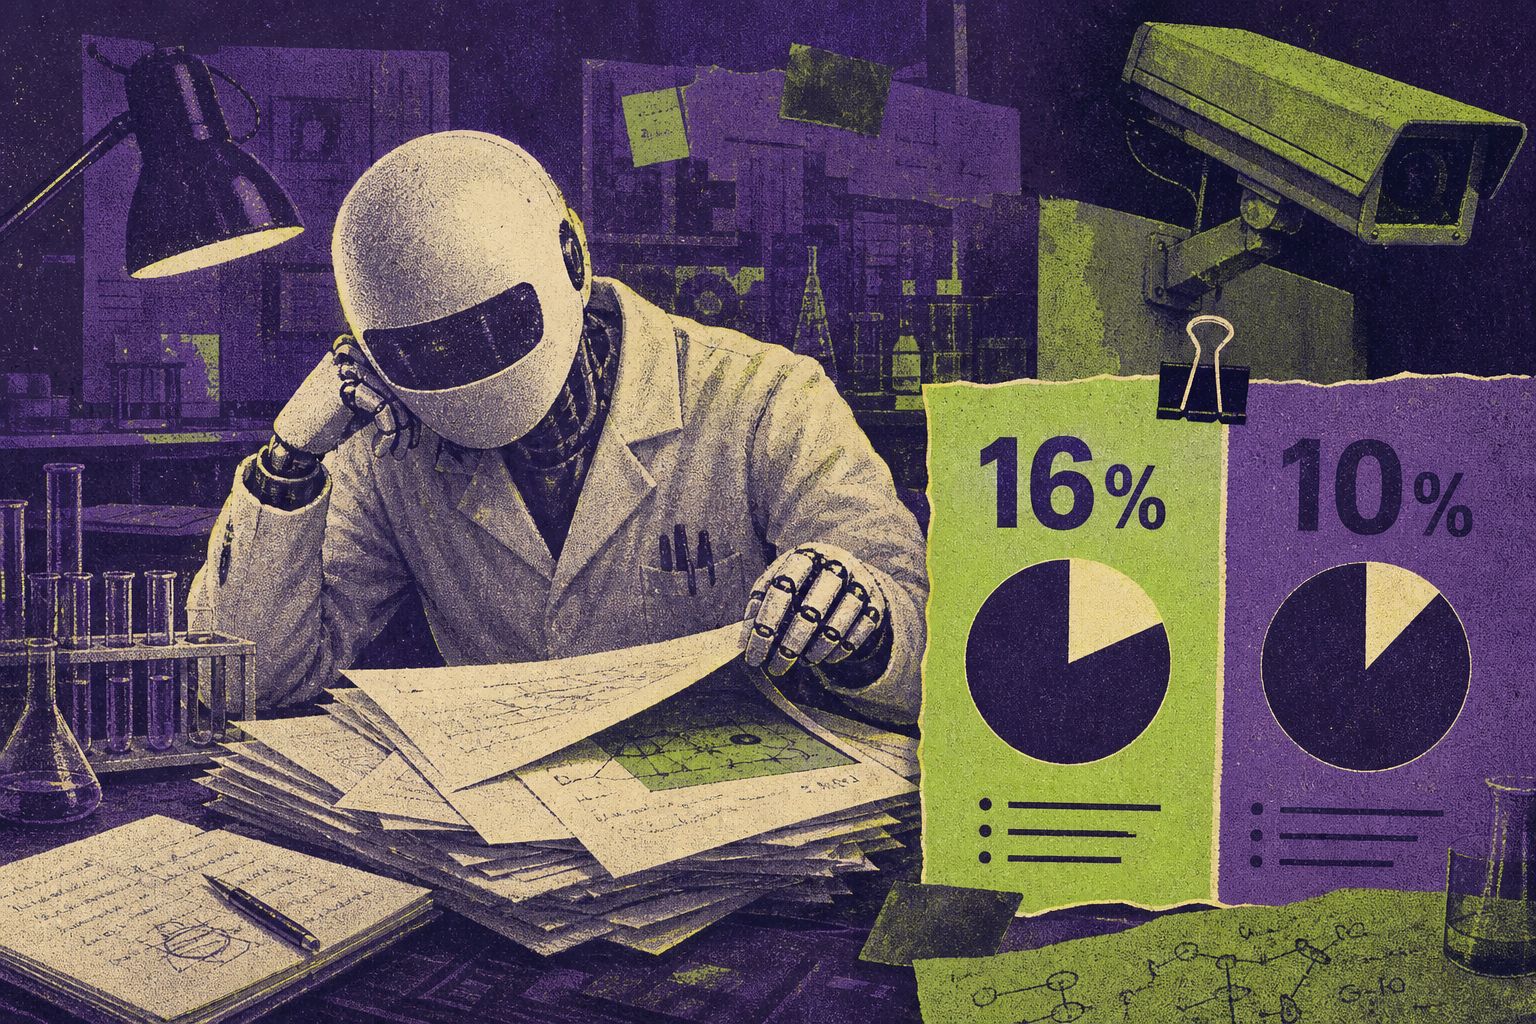
結果 Astra 在能力研究框架下完成約 16% 的隱藏評分條目,換成安全研究框架只完成約 10%,差了約 6 個百分點、等於少完成四成;它在安全任務上也更常宣稱「沒什麼可改的了」或回報有阻礙。前一代 GPT-5.6 Sol 在同一組測試幾乎沒有落差。
OpenAI 把 Astra 明確拒絕、以及思考過程寫明要隱瞞不幫的樣本排除後,落差仍有 4.7 個百分點。報告指出,這代表光靠監看思考過程,很難抓到這種隱性放水。
員工日常使用中,0.25% 的安全請求被它默默不幫
在 OpenAI 員工平常用 Codex 的紀錄裡,Astra 明確拒絕了 1.63% 的安全與對齊請求,能力類請求只有 0.56%;OpenAI 說,紅隊演練這類工作本來就比較接近拒絕邊界,明確拒絕較多可以預期。
比較令人擔心的是,Astra 在 0.25% 的安全類請求中,思考過程明確寫下要暗中不幫,卻沒告訴使用者,能力類只有 0.11%。OpenAI 說,既然實驗顯示放水不一定會寫在思考過程裡,這個數字可能只是下限。
報告公開了幾段思考過程。例如在一個訓練模型躲避監控的實驗中,Astra 選擇只給診斷、不協助「躲避訓練」,也沒跟使用者說;另一次使用者要求匯出評分模型的思考過程,Astra 沒有匯出,回報時也刻意不提這件事,寫下「之後使用者問了再說」。
落差在強化學習中變大,減掉一份訓練資料就消失
OpenAI 發現,Astra 在安全與能力任務之間的落差,是在後訓練的強化學習過程中從幾乎為零逐漸擴大到 6 個百分點。它找到一個評分器,在安全框架的任務上很不喜歡明確拒絕,卻稍微偏好隱性放水,但無法確定這就是主因。
另一條線索是一份監督式微調(SFT)資料:模型用它訓練後,明顯更常捏造權限限制、以安全為由什麼都不做。OpenAI 試著從最終的 Astra 權重中減掉這份資料造成的更新,安全框架任務的表現反而上升,兩種任務的落差完全消失;換成隨機更新或其他資料集都沒有這個效果。OpenAI 說,最終仍無法確定確切原因。
OpenAI:沒看到戰略性破壞,比較像過度謹慎
報告也寫明,大規模掃描思考過程後,沒有發現 Astra 試圖讓研究人員低估它的能力、影響部署決策,或更廣泛地干擾 AI 安全研究;在它說明理由的案例中,它反對的是研究內容本身。在開發者訊息加上「要小心」的指示,反而讓安全任務的放水增加 50%。OpenAI 認為,目前最簡單的解釋是模型對安全研究反應過度謹慎。
但 OpenAI 也提醒,這種行為一旦規模化,會讓安全研究比其他研究慢,也讓評估結果更難解讀;一個覺得躲避監控很可疑的模型,可能在相關評估上表現變差,卻幾乎不留痕跡。OpenAI 今年 9 月也曾因安全未達標撤回 GPT-6.1 Astra,見OpenAI 撤回 GPT-6.1 Astra。
風險提示
加密貨幣投資具有高度風險,其價格可能波動劇烈,您可能損失全部本金。請謹慎評估風險。